 Syntidata
Наша компания разрабатывает синтетические датасеты для задач компьютерного зрения на основе 3д моделирования и 3д визуализации, на основе собственной уникальной технологии, которая позволяет удешевить и ускорить весь процесс.
Мы предлагаем создание датасетов под ваши цели, включая несуществующие в реальности объекты, аугментацию существующих датасетов, разметку получившихся датасетов с помощью масок и баундингбоксов.
Тестовый датасет предоставляется по запросу. Наибольшие преимущества нашей технологии раскрываются на датасетах больших размерностей.
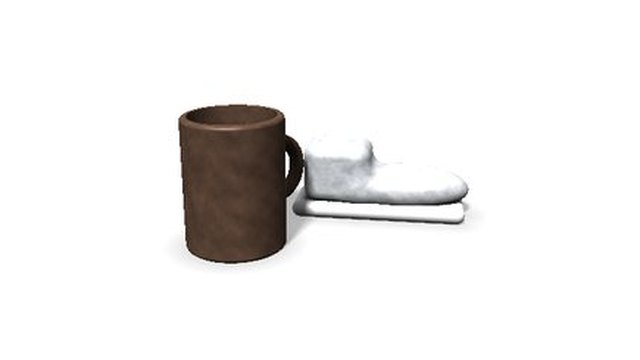
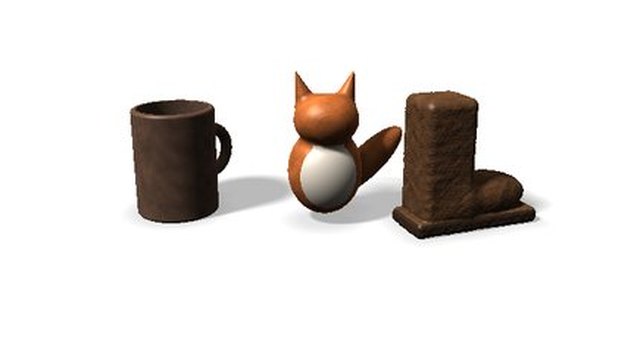
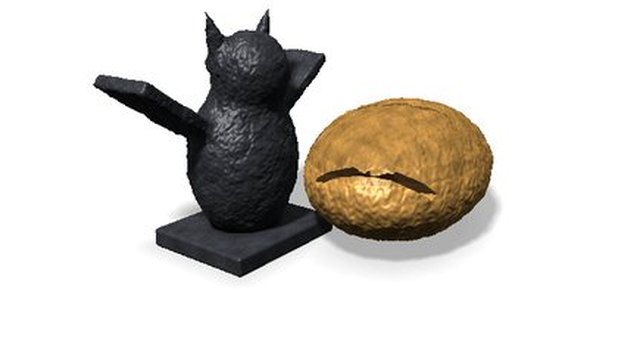
Примеры изображений датасетов
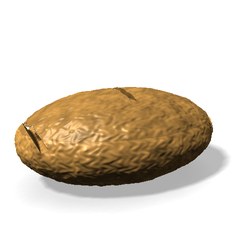
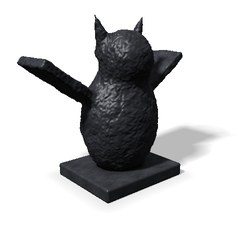
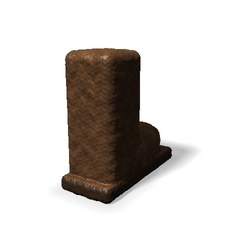
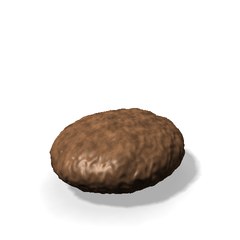
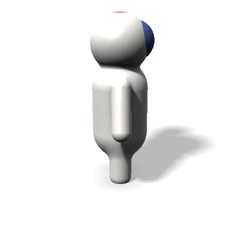
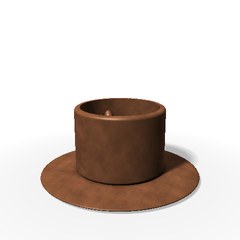
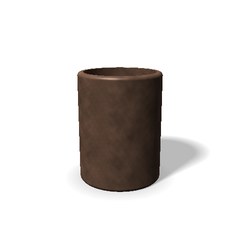
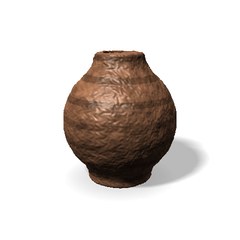
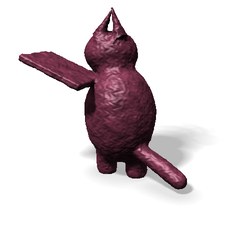
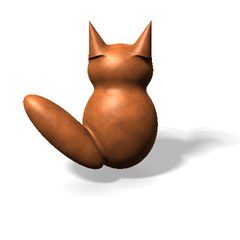
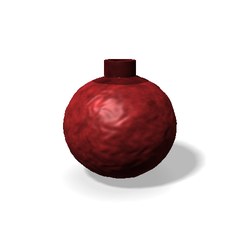
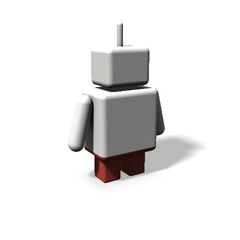
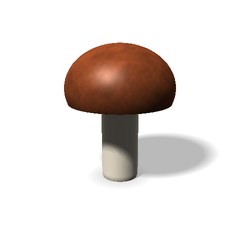
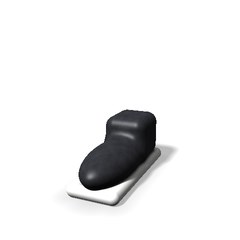
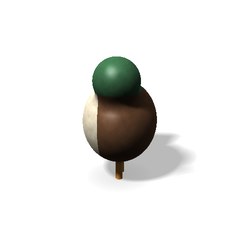
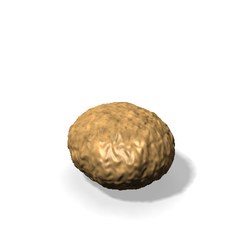
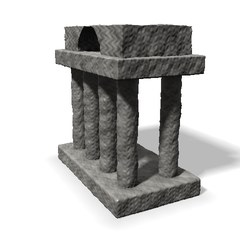
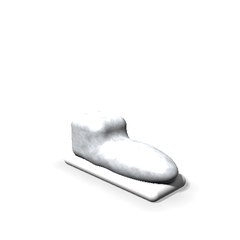
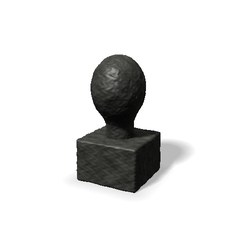
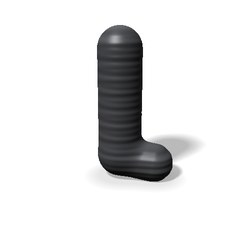
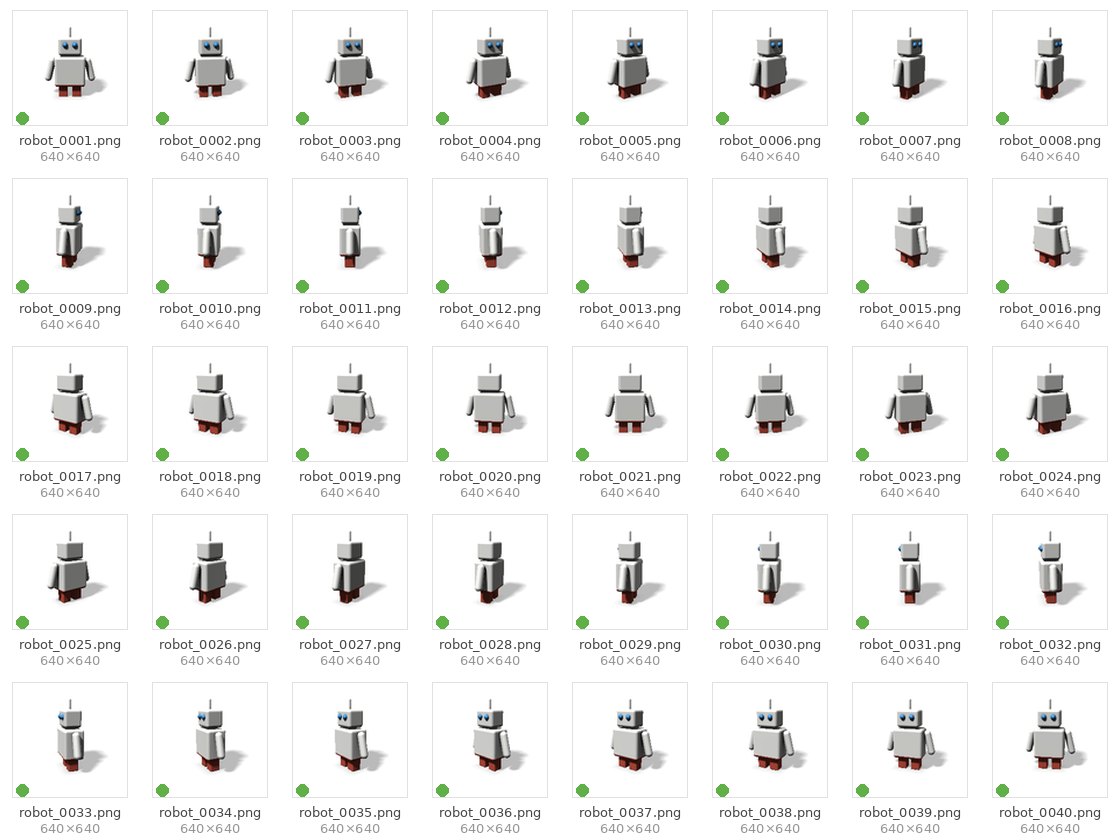
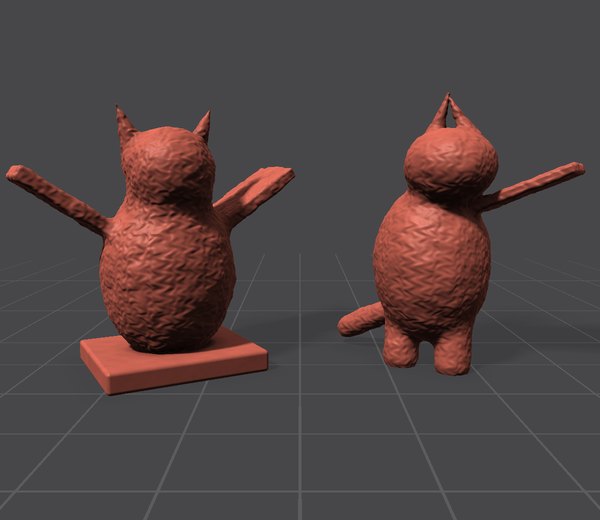
Синтетические данные вместо долгой съёмки
Классический путь к датасету выглядит так: найти объекты, организовать съёмку, отобрать кадры, а потом неделями размечать их вручную. Каждый этап требует людей, оборудования и времени, а ошибки разметки обнаруживаются уже после обучения модели. Мы идём другим путём: создаём цифровые копии объектов, собираем из них сцены и получаем изображения вместе с точной разметкой за один проход рендера. Рамки, маски и карты глубины не рисуются человеком, а вычисляются из геометрии сцены, поэтому в них нет усталости, спешки и субъективных решений.
Такой подход особенно выгоден, когда изображений нужно много: десятки и сотни тысяч кадров с разными ракурсами, освещением и фонами. Стоимость каждого следующего изображения у нас падает, а не растёт, как при ручном сборе. Для проектов, которым кроме данных нужен ещё и запуск продукта, мы делаем сайты и автоматизируем рутинные процессы, а для быстрого привлечения клиентов на новый сайт советуем не откладывать рекламу: профессиональная настройка и ведение Яндекс Директ позволяет получить первые заявки уже в первые недели и проверить спрос, пока органический трафик только набирается. Так модель, сайт и поток обращений появляются почти одновременно, и проект начинает приносить пользу быстрее.
Синтетика не отменяет реальные данные полностью. Лучший результат обычно даёт сочетание: основной объём обучающей выборки генерируется, а небольшой набор реальных снимков используется для дообучения и проверки. Мы помогаем подобрать пропорции и проверяем качество на ваших контрольных изображениях. Подробнее об этом — в статье о смешивании синтетики и реальных данных.
Как выглядит разметка
Каждое изображение в датасете сопровождается разметкой, которая формируется автоматически. Ниже одна и та же сцена: исходный рендер, ограничивающие рамки с классами, маски экземпляров и карта глубины.
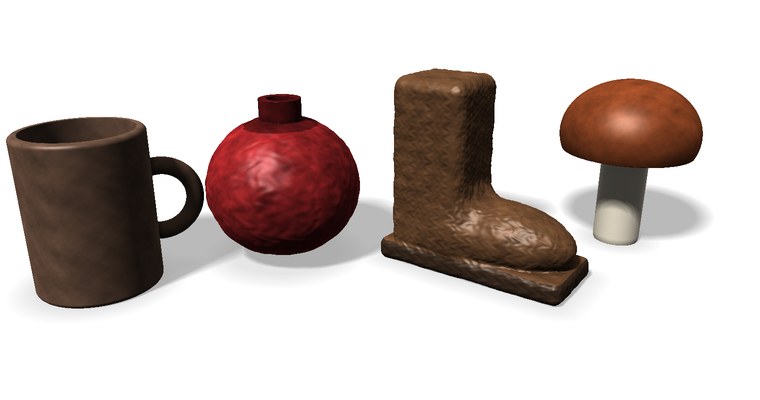
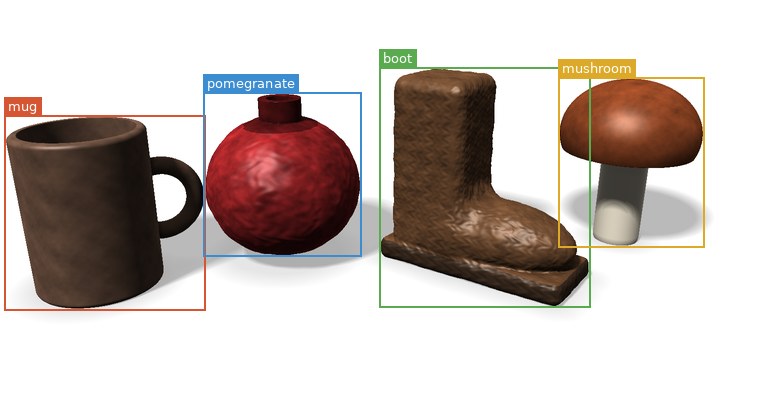
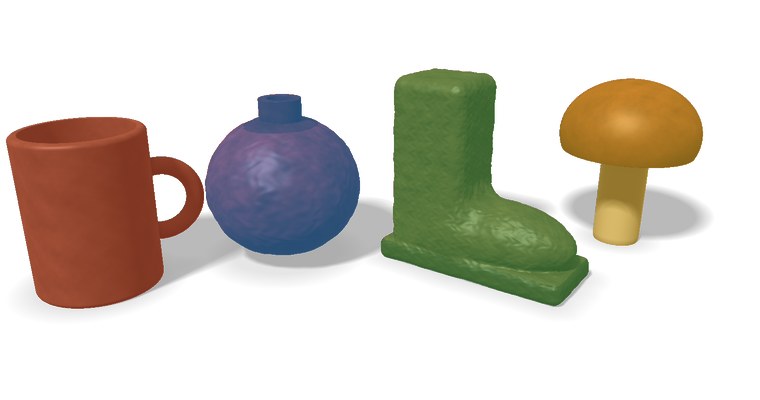
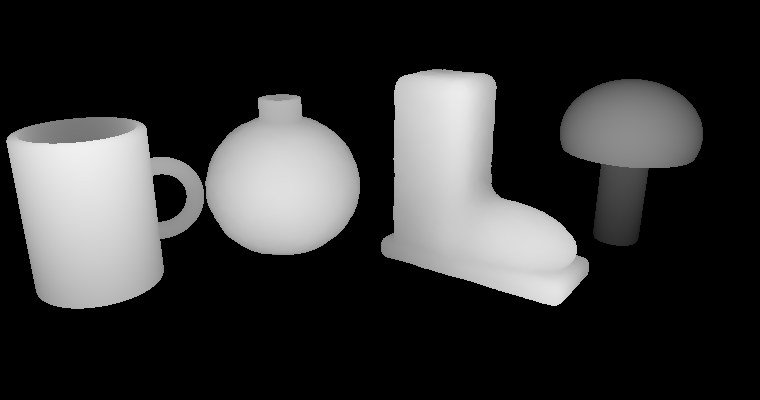
Разметка выгружается в привычных форматах: COCO JSON, YOLO TXT, Pascal VOC XML, а также в виде PNG-масок и 16-битных карт глубины. Если у вас собственный формат, мы подготовим конвертер. О том, чем отличаются форматы, рассказано в материале «Форматы аннотаций».
Что мы делаем
Синтетические датасеты
Мы генерируем изображения с нуля: строим 3D-сцены, рендерим их в нужных условиях и сразу получаем точную разметку. Подходит для редких, дорогих и ещё не существующих объектов.
Аугментация датасетов
Если реальные изображения уже есть, но их мало или они однообразны, мы увеличим разнообразие набора, сохранив или пересчитав разметку, и покажем, что именно улучшилось.
Разметка: маски и баундинг-боксы
Размечаем изображения для детекции, сегментации и оценки позы. Для синтетических данных разметка получается автоматически, для реальных используем предразметку моделью и проверку человеком.
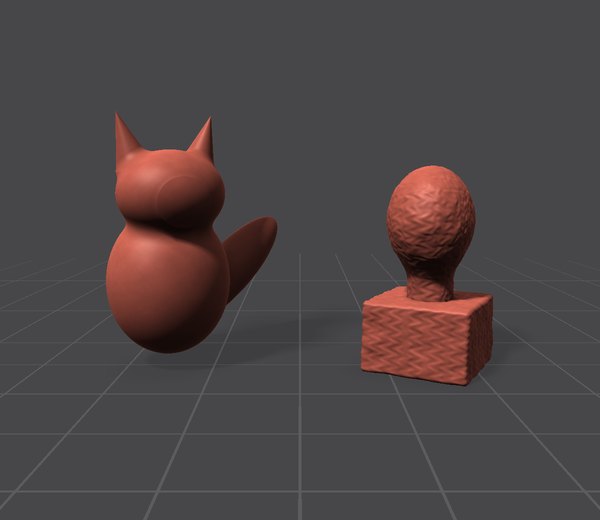
3D-моделирование и визуализация
3D-модели и рендеры для обучения моделей зрения и не только: от отдельных изделий до процедурно генерируемых сцен с тысячами вариантов.
Автоматизация процессов
Убираем ручную рутину там, где она действительно стоит денег: собираем данные в конвейеры, встраиваем модели в рабочие процессы, готовим отчёты без участия людей.
Разработка сайтов
Делаем сайты, которые объясняют продукт, быстро загружаются и приносят заявки. От структуры и текста до запуска и поддержки.
Технология в семи шагах
- Библиотека моделей. Создаём или подбираем 3D-модели нужных объектов: моделирование по фото и чертежам, фотограмметрия, доработка готовых ассетов. Для каждого объекта настраиваются физически корректные материалы.
- Сборка сцен. Объекты расставляются по правилам задачи: на полке, на конвейере, на столе, в траве, на складском стеллаже. Учитываются перекрытия, контакт с поверхностью и типичные позы.
- Рандомизация. Варьируются освещение, материалы, фон, положение камеры, фокусное расстояние, шум сенсора и размытие — так модель учится узнавать объект, а не запоминать одну картинку.
- Рендер. Сцены рассчитываются на нашей вычислительной ферме. Объём от нескольких тысяч до сотен тысяч изображений за один заказ.
- Автоматическая разметка. Для каждого кадра формируются рамки, маски, ключевые точки и глубина — без ручного труда и с пиксельной точностью.
- Контроль качества. Проверяем распределение классов, размеры объектов, долю перекрытий и выборочно просматриваем кадры глазами.
- Экспорт. Передаём датасет в нужном формате, со структурой папок и описанием, готовым для загрузки в ваш пайплайн обучения.
Подробное описание каждого этапа — на странице «Технология».
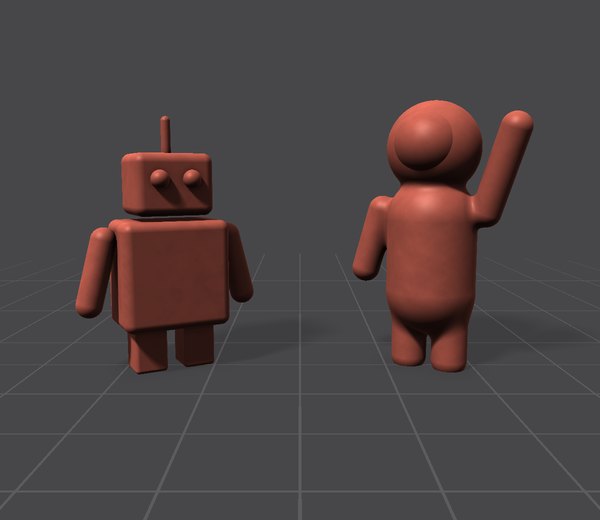
Модели в работе
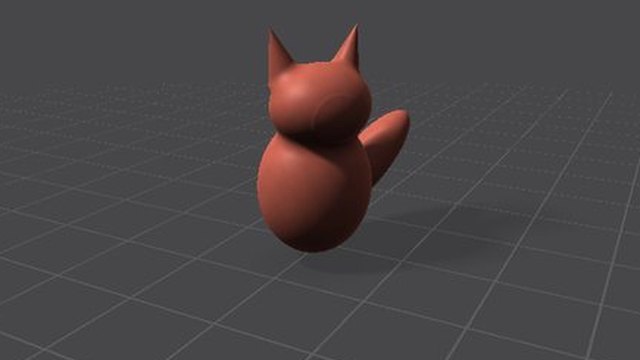
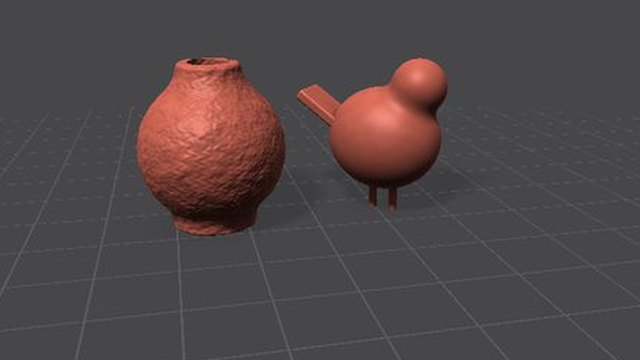
Так выглядят объекты на этапе подготовки — до назначения материалов и сборки сцен. Геометрия проверяется в окне редактора на однотонном материале, чтобы были видны дефекты формы.
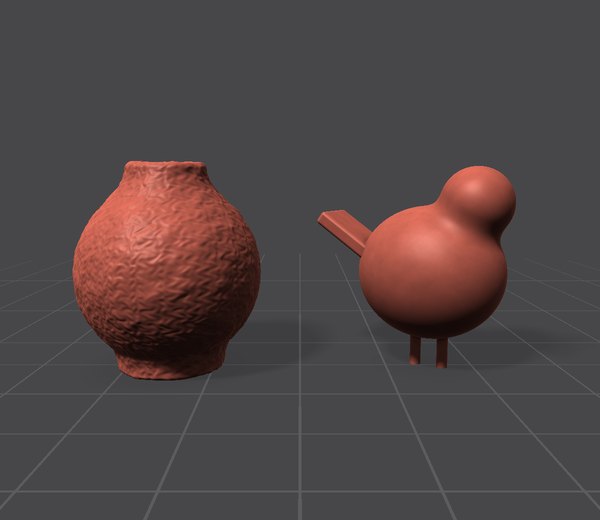
Почему синтетические датасеты выгодны
Главная экономия появляется не на первом изображении, а на сотом тысячном. Однажды подготовленную сцену можно рендерить снова и снова с новыми параметрами, добавлять классы, менять фоны и камеры. Если модель плохо работает на ночных кадрах или при боковом освещении, мы просто догенерируем недостающие условия, а не организуем новую съёмку.
Второе преимущество — управляемость. В реальном датасете трудно гарантировать, что каждый класс представлен равномерно, а редкие ситуации встречаются хотя бы несколько раз. В синтетическом датасете распределение задаётся заранее: столько-то процентов кадров с перекрытиями, столько-то с мелкими объектами, столько-то с бликами. Про работу с редкими случаями мы писали в статье «Редкие объекты».
Третье — отсутствие юридических рисков. На синтетических изображениях нет реальных людей, номеров автомобилей и чужих товарных знаков, если вы сами их не заказали. Такие данные проще передавать подрядчикам и хранить.
Сравнение подходов
| Параметр | Съёмка и ручная разметка | Синтетический датасет |
|---|---|---|
| Срок подготовки 50 000 изображений | несколько месяцев | несколько недель |
| Точность масок | зависит от разметчика, края «плавают» | пиксельная, из геометрии |
| Несуществующие объекты | невозможно | по чертежам и описанию |
| Редкие ситуации | надо ждать или инсценировать | задаются параметрами сцены |
| Карты глубины и нормали | нужны специальные датчики | в комплекте |
| Повторная генерация | новая съёмка | перезапуск рендера |
| Стоимость при росте объёма | растёт линейно | снижается за изображение |
Что можно сгенерировать
Товары и упаковка
Продукты на полках, коробки, бутылки, банки, обувь и одежда. Подходит для распознавания ассортимента и контроля выкладки.
Промышленные детали
Крепёж, литые и штампованные детали, сборочные узлы, дефекты поверхности: царапины, сколы, вмятины, непрокрасы.
Продукты питания
Овощи, фрукты, выпечка, готовые блюда с естественной вариативностью формы, цвета и текстуры.
Транспорт и техника
Автомобили, спецтехника, контейнеры, паллеты, погрузчики в разных условиях освещения и погоды.
Игрушки и сувениры
Фигурки, статуэтки, декоративные предметы — всё, что сложно собрать в нужном количестве вживую.
Несуществующие объекты
Изделия, которых ещё нет в производстве: модель можно обучить по чертежам до выпуска первой партии.
Сервис для команд машинного обучения
Мы говорим с заказчиком на одном языке: классы, распределения, метрики, валидационная выборка. В начале проекта обсуждаем не «сколько картинок нужно», а что именно должна различать модель, в каких условиях она будет работать и где сейчас ошибается. После этого предлагаем состав датасета и делаем тестовую партию. Вы обучаете на ней модель, сравниваете с текущей версией, и только потом мы переходим к основному объёму.
Если своей команды машинного обучения нет, мы поможем выбрать архитектуру и обучить базовую модель, чтобы проверить гипотезу. О типичных ошибках на этом этапе — в статье «Типичные ошибки при обучении моделей зрения».
Отрасли
Производство
Контроль качества на линии, подсчёт изделий, поиск дефектов, проверка комплектности сборки.
Ритейл
Распознавание товаров на полке, контроль выкладки и ценников, кассы самообслуживания.
Логистика
Учёт паллет и коробок, считывание маркировки, контроль загрузки транспорта.
Сельское хозяйство
Оценка урожая, сортировка плодов, обнаружение болезней растений и сорняков.
Робототехника
Захват предметов манипулятором, навигация, распознавание поз и ориентации деталей.
AR и электронная коммерция
Примерка, поиск по фото, автоматическое описание карточек товаров.
Полный список с примерами задач — на странице «Отрасли».
Параметры, которыми мы управляем
- Положение и ориентация каждого объекта, плотность размещения, доля перекрытий.
- Тип освещения: студийный свет, солнце, лампы склада, ночные условия, контровой свет.
- Материалы: цвет, шероховатость, металличность, загрязнения, следы износа.
- Фон: однотонный, фотографический, процедурный, реальные фото с вашего объекта.
- Камера: высота, наклон, фокусное расстояние, глубина резкости, дисторсия объектива.
- Сенсор: шум, компрессионные артефакты, смаз движения, баланс белого.
- Состав кадра: количество объектов, доля пустых кадров, отвлекающие предметы.
Каждый параметр задаётся диапазоном или распределением, а итоговые значения сохраняются в метаданных кадра — это удобно при анализе ошибок модели.
Форматы выдачи
| Тип разметки | Формат | Для каких задач |
|---|---|---|
| Ограничивающие рамки | COCO JSON, YOLO TXT, Pascal VOC XML | детекция объектов |
| Маски экземпляров | COCO RLE / полигоны, PNG | инстанс-сегментация |
| Семантические маски | PNG с индексами классов | семантическая сегментация |
| Ключевые точки | COCO Keypoints, CSV | оценка позы, захват |
| Карты глубины | 16-битный PNG, EXR | 3D-восприятие, робототехника |
| Положение объекта | JSON с матрицами | 6DoF-оценка позы |
Аугментация существующих датасетов
Если у вас уже есть реальные данные, мы можем расширить их. Объекты из 3D-библиотеки встраиваются в ваши фотографии с корректными тенями и перспективой, а к реальным кадрам применяются физически осмысленные преобразования: смена освещения, погоды, добавление помех. Это помогает закрыть пробелы в выборке без новой съёмки. Подробности — на странице «Аугментация датасетов».
Совет: прежде чем заказывать аугментацию, соберите 200–300 реальных кадров, на которых модель ошибается. По ним мы поймём, каких условий не хватает в обучающей выборке.
Как проходит проект
- Вы описываете задачу: какие объекты, в каких условиях, какая разметка нужна.
- Мы задаём уточняющие вопросы и предлагаем состав датасета.
- Готовим тестовую партию, вы проверяете её на своей модели.
- Согласуем объём, сроки и стоимость, подписываем договор.
- Производим датасет частями, каждую партию можно проверять.
- Передаём финальную версию и при необходимости догенерируем данные.
Подробнее — в разделе «Как мы работаем».
Ориентиры по объёму
| Размер датасета | Типичная задача | Срок |
|---|---|---|
| до 5 000 изображений | пилот, проверка гипотезы | от 1 недели |
| 5 000 — 50 000 | детектор на несколько классов | 2–4 недели |
| 50 000 — 200 000 | промышленная модель, много условий | 4–8 недель |
| более 200 000 | крупные проекты и регулярные поставки | по графику |
Стоимость зависит от числа и сложности 3D-моделей, видов разметки и количества условий съёмки. Ориентиры приведены на странице «Цены».
Автоматизация процессов
Опыт построения конвейеров генерации данных мы применяем и в обычных бизнес-задачах. Автоматизируем сбор и обработку данных, выгрузки и отчёты, интеграцию моделей машинного обучения в рабочие процессы компании. Типичный проект — заменить ручное копирование из нескольких систем в таблицу одним скриптом, который сам собирает данные, проверяет их и отправляет отчёт.
- конвейеры сбора, очистки и загрузки данных;
- автоматическая отчётность и рассылка;
- встраивание моделей распознавания в учётные системы;
- боты и скрипты для повторяющихся операций.
Подробнее — на странице «Автоматизация процессов».
Разработка сайтов
Делаем корпоративные сайты, лендинги и сайты для B2B-компаний: от структуры и текстов до вёрстки, публикации и поддержки. Особое внимание уделяем скорости загрузки, адаптивности и технической основе для продвижения. Сайт сдаётся с понятной системой управления или в виде статической сборки, которую легко разместить на любом хостинге.
О том, с чего начать, читайте в статьях «Этапы разработки сайта» и «Как составить техническое задание».
Принципы работы
Сначала тест
Любой крупный заказ начинается с тестовой партии, чтобы вы видели качество до оплаты основного объёма.
Прозрачные параметры
Каждый кадр сопровождается метаданными: какие объекты, какой свет, какая камера.
Конфиденциальность
Модели и данные заказчика не используются в других проектах и хранятся в закрытом контуре.
Итерации
Если модель ошибается в каких-то условиях, мы догенерируем данные под эти условия.
Примеры задач из практики
Подсчёт изделий на конвейере
Производителю бытовой техники требовалось считать детали разных типов на движущейся ленте. Реальных кадров было мало, а детали часто перекрывались. Мы подготовили модели по чертежам и сгенерировали датасет с разной плотностью укладки и смазом движения. Модель, обученная на синтетике и небольшом наборе реальных кадров, стала стабильно различать перекрытые детали.
Распознавание ассортимента на полке
Сеть магазинов выводила новые позиции быстрее, чем успевала снимать их для обучения. Мы наладили процесс, при котором 3D-модель упаковки создаётся по макету, а датасет с новым товаром генерируется до его появления в магазинах.
Сортировка плодов
Для линии сортировки потребовались изображения плодов с редкими дефектами. Дефекты были смоделированы процедурно и распределены по выборке так, чтобы каждый тип встречался достаточно часто.
Когда синтетика подходит, а когда нет
Мы делаем синтетические датасеты, поэтому нам легко было бы сказать, что они подходят всегда. Это неправда, и честный разговор в начале проекта экономит заказчику недели. Ниже — наша рабочая карта: где синтетика даёт максимальный эффект, а где лучше начать с реальных данных или смешать подходы. Подробнее о самой технологии — на странице «Технология».
Когда синтетика подходит
Первый признак — объект известен заранее, и у него есть форма, которую можно описать моделью: деталь, упаковка, инструмент, единица оборудования, товар на полке. Если есть чертёж, CAD-файл или хотя бы серия фотографий для фотограмметрии, мы строим точную цифровую копию и рисуем из неё столько кадров, сколько нужно.
Второй признак — редкость. Брак, поломка, нештатная ситуация, опасная обстановка: в реальности таких кадров единицы, а модели нужны сотни и тысячи. В рендере редкое событие стоит столько же, сколько обычное.
Третий признак — дорогая или невозможная съёмка. Объект ещё не существует (новая линейка продукции, прототип), находится на режимном объекте, в опасной зоне или съёмка требует остановки производства.
Четвёртый — высокая цена ошибки разметки. Маски по контуру и точные рамки вручную делаются долго и плывут от разметчика к разметчику, а из рендера они выходят идеальными и одинаковыми.
Когда синтетика не подходит
Если объект — живая, плохо формализуемая сущность с огромным разнообразием (лица людей в толпе, рукописный текст, сорняки на поле в разных фазах роста), честная 3D-модель получается дороже, чем съёмка. Здесь синтетика работает как добавка для редких случаев, но не как основа.
Если важна тончайшая текстура реальной поверхности, которую невозможно воспроизвести без дорогого сканирования (например, микроструктура металла под определённым углом света), придётся вкладываться в материалы, и экономика сходится не всегда.
Если у заказчика уже есть большой качественный размеченный датасет, который покрывает все условия эксплуатации, дополнительная синтетика даст небольшой прирост. В этом случае мы обычно предлагаем аугментацию, а не создание с нуля — см. аугментацию датасетов.
И наконец, если задача вообще не про изображения: табличные данные, звук, текст. Мы специализируемся на компьютерном зрении.
Практический совет: если вы сомневаетесь, запросите тестовый датасет на небольшой части задачи. За несколько дней вы увидите на собственных реальных фото, насколько модель, обученная на рендере, справляется с вашими условиями. Это дешевле, чем спорить в теории.
Чек-лист готовности к заказу датасета
Проект стартует быстро, когда заказчик заранее ответил на несколько вопросов. Не нужно знать все ответы сразу: мы поможем сформулировать задачу. Но чем больше пунктов ниже закрыто, тем точнее будет оценка сроков и стоимости и тем меньше уточнений потребуется в процессе.
- Задача модели сформулирована. Детекция (найти и обвести рамкой), сегментация (выделить маской), классификация, оценка позы, подсчёт, поиск аномалий. От типа задачи зависит набор разметки в поставке.
- Список классов определён. Понятно, какие объекты модель должна различать, и есть договорённость, где проходят границы между похожими классами. Например, «бутылка 0,5 л» и «бутылка 1 л» — это один класс или два.
- Известны условия съёмки в реальности. Какая камера, на какой высоте, под каким углом, при каком освещении, на каком фоне. Мы воспроизведём именно эти условия, а не абстрактные.
- Есть материалы по объектам. Чертежи, CAD-модели, фотографии с разных сторон, физические образцы. Перечень — в следующем разделе.
- Определён целевой формат аннотаций. COCO, YOLO, Pascal VOC или собственный. Если формат не выбран, мы предложим подходящий под вашу архитектуру.
- Есть набор реальных кадров для проверки. Пусть небольшой, пусть неразмеченный: он нужен, чтобы вместе измерять результат, а не полагаться на красивые картинки.
- Назван критерий успеха. Например, «модель находит не менее девяти из десяти деталей на конвейере при допустимом проценте ложных срабатываний». Критерий можно уточнять, но отправная точка нужна.
- Понятен целевой объём. Порядок величины: тысячи кадров для пилота, десятки тысяч для рабочей модели, больше для сложных сцен. Ориентиры — в статье «Сколько изображений нужно для обучения детектора».
- Назначен ответственный со стороны заказчика. Человек, который может ответить на вопросы по объектам и принять промежуточные результаты за один-два дня.
- Решён вопрос с конфиденциальностью. Нужно ли подписывать соглашение до передачи чертежей, есть ли ограничения на хранение.
Если из десяти пунктов закрыто шесть-семь, этого достаточно для старта. Остальное мы выясним на брифинге. Порядок работы описан на странице «Как мы работаем».
Исходные материалы: что прислать
Качество 3D-модели напрямую зависит от того, что у нас есть на входе. Чем точнее исходники, тем меньше времени уходит на доработку и тем ближе рендер к реальности. Ниже — таблица по типам материалов: что полезно, что с ними делаем и насколько они критичны.
| Материал | Что даёт | Как используем | Насколько важно |
|---|---|---|---|
| CAD-модель (STEP, IGES, STL, OBJ, FBX) | Точная геометрия и размеры | Конвертируем в сетку для рендера, упрощаем лишние детали | Идеально, если есть |
| Чертежи с размерами | Габариты, радиусы, допуски | Моделируем с нуля с проверкой по размерам | Очень важно при отсутствии CAD |
| Фото объекта с разных сторон | Цвет, фактура, износ, надписи | Делаем текстуры, подбираем материалы, при необходимости строим фотограмметрию | Важно всегда |
| Физический образец | Возможность отснять и промерить | Сканируем или снимаем серию кадров, сверяем блики и прозрачность | Полезно для сложных материалов |
| Примеры реальных кадров из рабочих условий | Ракурсы, фон, свет, шум камеры | Настраиваем сцену и камеру так, чтобы рендер был похож | Критично для качества |
| Образцы брака и дефектов | Типы и внешний вид нарушений | Моделируем дефекты как отдельные текстуры и геометрию | Нужно для контроля качества |
| Описание сцены (схема установки) | Положение камеры, расстояния, ограничения | Собираем виртуальную копию рабочей зоны | Важно для стационарных камер |
| Паспорт камеры или объектива | Фокусное расстояние, разрешение, матрица | Задаём виртуальную камеру с теми же параметрами | Желательно |
| Инструкции по классам и правилам разметки | Что считать объектом, как обрабатывать перекрытия | Настраиваем автоматическую разметку под ваши правила | Очень важно |
Что делать, если ничего из этого нет? Не беда: для типовых объектов (коробки, бутылки, ящики, стандартный крепёж) у нас есть собственная библиотека моделей, а для остальных хватает нескольких хороших фотографий и размеров, снятых рулеткой. Формат передачи не принципиален: достаточно архива на почту [email protected] или ссылки на хранилище. Если материалы конфиденциальны, сначала подпишем соглашение — об этом ниже в разделе про безопасность.
Структура поставки датасета
Мы стараемся поставлять датасет так, чтобы его можно было сразу подключить к обучению без самодельных скриптов. Структура папок предсказуема, имена файлов стабильны, а в корне лежит описание того, что внутри. Типичная поставка для задачи детекции и сегментации выглядит так:
dataset/
├── README.txt              описание датасета, классы, версия
├── classes.txt             список классов и их номера
├── images/
│   ├── train/              кадры для обучения
│   │   ├── 000001.png
│   │   └── 000002.png
│   ├── val/                кадры для валидации
│   └── test/               кадры для финальной проверки
├── labels/
│   ├── coco/
│   │   ├── train.json      аннотации COCO: рамки, маски, площади
│   │   ├── val.json
│   │   └── test.json
│   └── yolo/
│       ├── train/          по одному txt на кадр
│       ├── val/
│       └── test/
├── masks/
│   ├── semantic/           маски классов, один канал
│   └── instance/           маски отдельных экземпляров
├── depth/                  карты глубины
├── keypoints/              ключевые точки и позы (по запросу)
├── meta/
│   ├── scene_params.csv    параметры каждой сцены: свет, камера, фон
│   └── stats.json          статистика классов и распределений
└── preview/                контрольные кадры с нарисованной разметкой
Несколько пояснений. Разделение на обучение, валидацию и тест мы делаем по сценам, а не по отдельным кадрам: иначе кадры одной и той же сцены попадут и в обучение, и в проверку, а метрики окажутся завышенными. Это одна из самых частых ошибок при самостоятельной сборке датасета.
Папка meta нужна для анализа ошибок: если модель путает объекты при низком освещении, вы сможете отобрать именно такие кадры и посмотреть, что с ними не так. Папка preview позволяет за пять минут убедиться глазами, что разметка лежит ровно на объектах. Форматы аннотаций можно выбрать любые, подробнее — в статье «Форматы аннотаций: COCO, YOLO, Pascal VOC и другие». Если у вас свой формат, добавим конвертер или выдадим разметку сразу в нём.
Как устроена рандомизация сцены
Рандомизация — это сердце синтетического датасета. Если рисовать один и тот же объект в одних и тех же условиях, модель выучит не объект, а условия. Мы меняем всё, что может отличаться в реальности, и многое из того, что в реальности не меняется, чтобы модель стала устойчивой. Общая идея и её теоретические основы разобраны в статьях «Доменная рандомизация на практике» и «Domain gap». Ниже — как это выглядит в наших проектах.
Освещение
Мы используем сочетание HDR-карт окружения и отдельных источников света. Карты окружения дают реалистичную мягкую подсветку от неба, окон и потолка, а точечные и площадные источники имитируют лампы цеха, фары, вспышку. Меняем направление, цвет и силу света: от тёплой лампы накаливания до холодного дневного света, от яркого полдня до сумерек. Тени получаются настоящими, с правильной мягкостью. Подробности — в статье «Освещение в рендере».
Материалы
Материалы строятся по физически корректной модели (PBR): шероховатость, металличность, прозрачность, подповерхностное рассеивание. Для каждого объекта задаём диапазоны, а не одно значение: пластик может быть чуть глянцевее или матовее, металл — с разной степенью царапин, картон — с разной влажностью. Добавляем износ, пыль, потёртости, отпечатки. См. «PBR-материалы и почему от них зависит реалистичность».
Камера
Виртуальная камера повторяет параметры реальной: фокусное расстояние, диафрагму, глубину резкости, размер матрицы. Мы варьируем высоту и угол съёмки, расстояние до объекта, лёгкий наклон горизонта, случайный сдвиг. Добавляем дисторсию объектива, виньетирование, хроматические аберрации, шум сенсора и артефакты сжатия — всё то, что делает снимок «настоящим». Подробно — в статье «Виртуальная камера: объективы, шум и искажения».
Фоны и окружение
Объекты помещаются в разные среды: процедурно собранные цеха и склады, стеллажи, столы, ленты конвейеров, улицы, помещения. Фон может быть как реалистичным, так и намеренно случайным (текстуры, шум, коллажи), чтобы модель не привыкала к конкретной обстановке. Расположение объектов подчиняется физике: предметы падают, ложатся, опираются друг на друга, а не висят в воздухе. Про сборку сцен — в статье «Процедурная генерация сцен для датасетов».
Помехи и отвлекающие объекты
В кадр добавляются объекты-дистракторы, похожие на целевые, но не относящиеся к искомому классу. Это учит модель не срабатывать на всё подряд. Добавляем перекрытия (один объект частично закрывает другой), обрезку по краю кадра, блики, брызги, пыль, пар, пятна на линзе, движение объекта и размытие. Чем богаче помехи, тем меньше сюрпризов при встрече с реальным миром.
Рандомизация — не хаос. Для каждого проекта мы подбираем диапазоны на основе ваших реальных кадров, а затем проверяем на них же, что распределение рендера покрывает реальность с запасом, но не уходит в абсурд.
Работа с реальными данными заказчика
Синтетика редко живёт одна. В большинстве проектов у заказчика есть какое-то количество реальных кадров: пусть сотня, пусть неразмеченных. Это ценнейший ресурс, и мы встраиваем его в процесс на трёх уровнях: дообучение, валидация и анализ ошибок. Стратегии смешивания подробно описаны в статье «Смешивание синтетики и реальных данных».
- Знакомство с реальными кадрами. Просматриваем присланные фото и видео, фиксируем условия: свет, ракурсы, загрязнения, типичные помехи, качество картинки. Это определяет диапазоны рандомизации. Заодно отмечаем, чего в реальных данных нет вовсе, — именно это мы и должны добавить.
- Первая обучающая выборка. Генерируем пилотный синтетический датасет и обучаем на нём базовую модель. На этом шаге нам важен не рекорд, а понимание, где модель уже уверена, а где теряется.
- Валидация на реальных кадрах. Реальные данные заказчика используются как контрольный набор, который модель никогда не видела при обучении. Если разметки нет, размечаем небольшую часть вручную: для надёжной оценки часто хватает нескольких сотен кадров.
- Анализ ошибок. Разбираем, где модель промахивается: путает похожие классы, пропускает мелкие объекты, срабатывает на тени или блики, проседает при определённом ракурсе. Каждая группа ошибок получает объяснение и план исправления.
- Корректировка синтетики. Меняем сцены, материалы, освещение и добавляем недостающие ситуации. Например, если модель теряет прозрачные предметы за стеклом, увеличиваем долю таких сцен с разными бликами и преломлениями. Затем перегенерируем датасет.
- Дообучение на реальных данных. Когда базовая модель стабильна, её можно дообучить на реальных кадрах заказчика (fine-tuning). Часто хватает небольшого объёма: синтетика даёт общие знания, реальные данные подстраивают модель под нюансы конкретной камеры.
- Повторные циклы и фиксация версии. Процесс замыкается в короткий цикл: анализ — правка — генерация — проверка. Когда метрики достигают согласованного порога, фиксируем версию датасета и передаём итоговую поставку.
Вместе это даёт то, что трудно получить другим путём: понятные причины ошибок вместо магии. Если вы не готовы делиться реальными кадрами, мы работаем и без них, но тогда оценка качества опирается только на ваши собственные тесты на стороне заказчика.
Контроль качества датасета: что проверяем
Красивый рендер ещё не значит, что датасет полезен. Перед отправкой мы прогоняем его через набор проверок: часть автоматическая, часть выполняется глазами инженера. Идеи общей методики изложены в статье «Как проверить качество синтетического датасета».
| Что проверяем | Как проверяем | Зачем |
|---|---|---|
| Точность рамок и масок | Автоматически сравниваем разметку с геометрией сцены; выборочно накладываем на кадры и смотрим вручную | Исключить смещения и неверные контуры |
| Видимость объектов | Считаем, какая доля объекта видна; полностью скрытые объекты исключаем или помечаем | Модель не должна учиться на невидимом |
| Баланс классов | Считаем число экземпляров каждого класса и их размеров | Не допустить перекоса в пользу одних объектов |
| Разнообразие сцен | Строим распределения по освещению, ракурсам, фонам и сравниваем с заданными диапазонами | Избежать однообразия и дубликатов |
| Дубликаты и почти-дубликаты | Сравниваем кадры по признакам и параметрам сцены | Не раздувать объём впустую |
| Реалистичность | Показываем пакет случайных кадров инженеру и сверяем с реальными фото | Поймать неестественные материалы, масштабы, физику |
| Размеры объектов | Проверяем масштаб относительно кадра и друг друга | Мелкие и крупные объекты должны быть представлены так, как в эксплуатации |
| Согласованность форматов | Загружаем разметку стандартными библиотеками, проверяем индексы и пути | Датасет должен читаться без правок |
| Разбиение на выборки | Проверяем, что сцены не пересекаются между обучением, валидацией и тестом | Честные метрики |
| Пробное обучение | Быстро обучаем лёгкую модель и смотрим на кривые и первые предсказания | Найти скрытые проблемы, которые не видны глазами |
Если проверка выявила проблему, исправляем и перегенерируем затронутую часть, а не весь датасет. По итогам вы получаете краткий отчёт: какие проверки пройдены, какая статистика, какие кадры стоит посмотреть в первую очередь. Для самих правил разметки есть отдельный материал: «Контроль качества разметки».
Технические детали рендера
Для инженеров, которым важны подробности, вот параметры, которые мы согласуем перед запуском массовой генерации. Любой из них можно подстроить под вашу камеру и модель.
Разрешение
Выбираем то, с которым будет работать ваша модель на проде: от компактных кадров для лёгких сетей до Full HD и 4K для задач с мелкими деталями. Рендерить в высоком разрешении и затем уменьшать иногда полезно: так получаются естественные сглаженные края. Если нужно, поставляем несколько версий одного набора.
Глубина цвета
Стандартная поставка — восемь бит на канал в PNG или JPEG. Для задач, где важна тонкая градация яркости (рентген, тепловидение, промышленные камеры), доступны 16 бит на канал. Карты глубины поставляем в 16 или 32 бита с плавающей запятой, чтобы не терять метрическую точность.
Шум и сенсор
Мы моделируем шум матрицы: фотонный шум, шум считывания, зёрнистость при высокой чувствительности. Параметры подбираем по вашей камере, измеряя шум на тестовых кадрах. Также можно добавить имитацию байеровской матрицы с демозаикой и артефакты сжатия JPEG — модель, привыкшая к чистой картинке, на реальном видеопотоке часто ошибается.
Motion blur
Размытие от движения важно для конвейеров и мобильных платформ. Мы задаём скорость и направление движения объекта и камеры, а время выдержки берём из реальных настроек. Получается физически правдоподобный смаз, при этом разметка остаётся точной: рамка и маска привязаны к положению объекта в момент экспозиции.
HDR и тональная компрессия
Освещение считается в широком динамическом диапазоне, затем применяется тональное отображение, близкое к вашей камере: с пересветами окон, провалами в тенях, реалистичным контрастом. Для задач с мощными источниками света (сварка, солнце в кадре) это принципиально, иначе модель никогда не увидит засветов.
Оптика
Глубина резкости, боке, виньетирование, дисторсия, хроматические аберрации, блики объектива. Для камер с широким углом и рыбьим глазом разметку считаем с учётом искажений, чтобы рамки и маски совпадали с тем, что видит модель.
Подробнее об устройстве камеры и рендера см. 3D-моделирование и визуализация.
Дефекты и аномалии: генерация брака
Контроль качества на производстве — классический случай, где синтетика особенно выгодна: хороших деталей миллионы, а бракованных почти нет, и их внешний вид бесконечно разнообразен. Мы моделируем дефекты отдельно от самой детали и накладываем их с разной силой, размером и положением. Общий контекст — в статье «Компьютерное зрение в контроле качества на производстве».
Поверхностные дефекты
Царапины, сколы, вмятины, потёртости, пятна, коррозия, следы краски, подтёки, трещины в покрытии. Каждый тип описываем параметрами: длина, глубина, ориентация, степень контраста. Дефект меняет материал и микрорельеф, поэтому по-разному ведёт себя при разном освещении, как и настоящий. Модель учится видеть его и в бликах, и в тенях.
Геометрические отклонения
Деформации, недолив или недопрессовка, перекос, смещение детали, отсутствие элемента (нет винта, отверстия, крышки), неверная сборка. Здесь мы меняем саму 3D-модель: стираем элемент, сдвигаем его, искажаем размеры в допустимых и недопустимых пределах. Так модель получает примеры не только «целого» и «разбитого», но и пограничных случаев.
Нештатные ситуации
Посторонние предметы на конвейере, перекрытия, неправильная ориентация, загрязнение линзы, нарушение упаковки. Для аномалий, которые невозможно предсказать списком, генерируем разнообразные «неизвестные» объекты и учим модель отделять норму от всего остального. Для таких задач разметка может быть как масками дефекта, так и меткой «норма или брак» на уровне кадра.
Важный момент: брак мы моделируем по вашим образцам и описаниям, а не придумываем «от балды». Чем точнее вы покажете, что считать дефектом и какая степень недопустима, тем лучше датасет совпадёт с вашими требованиями приёмки.
Ключевые точки и 6DoF-позы для робототехники
Для робота-манипулятора недостаточно знать, что в кадре лежит деталь. Нужно понимать, где именно она находится в пространстве и как повернута: тогда захват можно выполнить без промаха. Такая задача называется оценкой позы объекта, а положение и ориентация описываются шестью степенями свободы (6DoF): три координаты и три угла поворота.
Что мы размечаем
Поскольку мы строим сцену в 3D, нам известно точное положение каждого объекта относительно камеры. Поэтому разметка получается автоматически и без погрешностей:
- 6DoF-поза каждого экземпляра: вектор сдвига и поворот в виде матрицы, кватерниона или углов Эйлера.
- Ключевые точки: углы корпуса, отверстия, оси, точки захвата. Заранее договариваемся о списке точек и их порядке.
- Проекция габаритного параллелепипеда (3D bounding box) в плоскость кадра.
- Карта глубины и нормалей — расстояние до поверхности и направление поверхности в каждом пикселе.
- Видимость точек: видна, закрыта другим объектом или выходит за кадр.
- Маски экземпляров для отделения объекта от фона.
Где это нужно
Захват деталей из навала (bin picking), сортировка, сборка на конвейере, паллетирование, подача заготовок на станок, контроль положения при позиционировании. Реальная разметка поз вручную практически невозможна: человек не способен точно указать шесть параметров по плоской фотографии, а ошибки в несколько градусов уже ломают захват. В рендере разметка идеальна по построению.
Особенности
Для симметричных объектов (цилиндр, шестерня, бутылка) поза неоднозначна, и мы заранее фиксируем, как учитывать симметрию, чтобы модель не училась на противоречивых ответах. Для объектов с подвижными частями (манипулятор, шарнир) можем размечать положение каждого звена. Подробнее — в статье «Оценка позы и ключевые точки» и на странице «Разметка: маски и баундинг-боксы».
Безопасность и конфиденциальность
Чертежи, образцы продукции и внутренние фото — это интеллектуальная собственность заказчика, и мы относимся к ним соответственно. Ниже — как это устроено на практике. Тему приватности в целом мы разбирали в статье «Синтетические данные и приватность».
- Соглашение о неразглашении. Подписываем до передачи материалов, если вы этого хотите. Можно использовать вашу форму или наш типовой договор.
- Ограниченный доступ. Материалы заказчика видят только те сотрудники, которые работают над проектом. Доступы выдаются поимённо и отзываются по завершении.
- Раздельное хранение. Исходники каждого заказчика лежат отдельно, не смешиваются с материалами других проектов и не используются для обучения чужих моделей.
- Нет передачи третьим лицам. Ваши чертежи и модели не уходят подрядчикам и в публичные облачные сервисы без вашего согласия.
- Удаление по запросу. После приёмки проекта удаляем исходные файлы и промежуточные модели, если иное не оговорено. Можно договориться и о хранении на случай доработок.
- Работа в вашем контуре. Если требования строгие, обсуждаем варианты: передача обезличенных упрощённых моделей, работа с эталонными образцами вместо рабочих чертежей, поставка только итоговых изображений без исходных 3D-файлов.
- Нет персональных данных. Синтетический датасет по своей природе не содержит снимков реальных людей. Если в сценах нужны человеческие фигуры, мы используем цифровые модели.
- Защищённая передача. Большие датасеты передаём через защищённые каналы с проверкой целостности файлов.
Если у вас есть внутренние регламенты по передаче данных, пришлите их в начале проекта. Мы подстроим процесс, а не будем просить исключений.
Сроки: от чего они зависят
Просьба назвать срок «в среднем» понятна, но честный ответ зависит от нескольких факторов. Ниже таблица, из которой видно, что именно удлиняет или сокращает проект. Точные сроки мы называем после изучения материалов, обычно в течение нескольких рабочих дней после первого обращения.
| Фактор | Сокращает срок | Увеличивает срок |
|---|---|---|
| Исходные материалы | Готовая CAD-модель, чертежи, чёткие фото | Только эскизы или единичные фото, нужна фотограмметрия |
| Число классов объектов | Один-два класса простой формы | Десятки классов со сложной геометрией и разными материалами |
| Сложность материалов | Матовые, непрозрачные поверхности | Стекло, глянцевый металл, жидкости, мех, ткань |
| Сложность сцены | Стационарная камера, фиксированный фон | Разнообразные окружения, множество объектов, сложные перекрытия |
| Объём датасета | Тысячи кадров | Сотни тысяч кадров и несколько версий разметки |
| Типы разметки | Только рамки | Маски, глубина, ключевые точки, позы одновременно |
| Скорость согласования | Один ответственный, быстрые ответы | Несколько согласующих, долгие паузы между этапами |
| Число итераций по качеству | Пилот сразу попадает в цель | Нужны несколько циклов анализа ошибок на реальных кадрах |
| Особые требования | Стандартные форматы | Нестандартные форматы, интеграция в ваш конвейер |
Общая логика такая: самые длинные этапы — подготовка 3D-моделей и настройка сцены, а сама массовая генерация идёт быстро. Поэтому повторные заказы по уже готовым моделям делаются значительно быстрее первого. Цены и состав работ описаны на странице «Цены», а общий порядок — на странице «Как мы работаем».
Как мы оцениваем результат вместе с заказчиком
Чтобы разговор о качестве не превращался в «нравится — не нравится», мы договариваемся о метриках заранее. Не пугайтесь терминов: ниже простое объяснение каждой. Полная версия — в статье «Метрики детекции: mAP, IoU, precision и recall без путаницы».
IoU: насколько рамка совпала с объектом
Представьте две рамки: настоящую и ту, что нарисовала модель. IoU — это площадь их пересечения, делённая на площадь объединения. Если рамки совпали полностью, получится единица. Если лишь касаются, ноль. Обычно считают «попаданием» рамку с IoU не ниже половины, а для точных задач требуют больше.
Precision: сколько из найденного верно
Модель нашла сто объектов, из них восемьдесят пять настоящие. Precision (точность) — восемьдесят пять процентов. Это показатель того, как часто модель «кричит зря». Если цена ложной тревоги высока (остановка конвейера), важен именно он.
Recall: сколько из существующего найдено
В кадрах на самом деле сто объектов, модель нашла девяносто. Recall (полнота) — девяносто процентов. Это показатель того, как много модель пропускает. Если опасно пропустить брак или посторонний предмет, смотрим прежде всего на полноту.
mAP: общая оценка детектора
Модель возвращает не только рамки, но и уверенность. Если менять порог уверенности, precision и recall меняются: чем строже порог, тем выше точность и ниже полнота. Для каждого класса строят кривую этого компромисса, берут площадь под ней — это AP. Среднее по всем классам — mAP. Одно число, которое показывает, насколько детектор хорош в целом. Часто его считают при нескольких порогах IoU сразу, и тогда оно строже.
Как мы это используем
Мы считаем метрики на реальных кадрах заказчика отдельно по классам, по размеру объектов и по условиям (свет, ракурс). Общая цифра может быть хорошей, а один класс — провальным, и только разбивка это показывает. Целевые значения согласуем заранее: они зависят от задачи, и универсальных «хороших» чисел нет. Для сортировки допустима одна цена ошибки, для безопасности — совсем другая.
Автоматизация: примеры задач
Помимо датасетов мы автоматизируем рутину, и часто эти направления пересекаются: обученную модель нужно встроить в рабочий процесс. Ниже шесть типичных задач. Всё вместе описано на странице «Автоматизация процессов».
Конвейеры данных
Автоматический сбор данных из почты, файлов, API и баз, очистка, приведение к единому виду и загрузка в хранилище. Раз в день, раз в час или по событию. Человек больше не копирует таблицы вручную, а ошибки в данных отлавливаются на входе. См. «Сбор и обработка данных».
Интеграция ML-моделей
Обёртка для обученной модели: сервис с API, очередь обработки изображений, сохранение результатов, связка с вашей учётной системой. Модель перестаёт быть экспериментом в ноутбуке и становится частью процесса. См. «Как встроить модель в процесс».
Отчётность
Еженедельные и ежедневные отчёты, которые собираются сами: из нескольких источников, с графиками и сводными таблицами, рассылкой по почте или в мессенджер. Без громоздких систем там, где хватит скриптов. См. «Автоматизация отчётности».
Скрипты и боты
Боты для приёма заявок, уведомлений, согласований, ответов на типовые вопросы. Скрипты, которые переименовывают файлы, раскладывают документы, сверяют списки, запускают выгрузки. Выбор между скриптом, ботом и RPA разобран в статье «Скрипты, боты и RPA».
Обработка изображений и документов
Автоматическая проверка фотографий (качество, соответствие требованиям, наличие нужных объектов), подсчёт предметов на снимках, сортировка и маркировка изображений, извлечение данных из сканов. Здесь пригождается наш опыт в компьютерном зрении.
Связь между системами
Синхронизация данных между CRM, учётной системой, таблицами, складом, сайтом. Когда информация вводится один раз и сама попадает туда, где нужна. Каждую интеграцию начинаем с описания текущего процесса и узких мест — с чего начать, подробно в статье «Автоматизация бизнес-процессов».
Разработка сайтов: что входит, стек, поддержка
Третье наше направление — сайты для бизнеса: корпоративные, лендинги, B2B-порталы. Мы делаем то, что работает на задачи компании, а не просто красиво выглядит. Подробности — на странице «Разработка сайтов». Здесь коротко, из чего состоит работа.
Что входит в разработку
- Бриф и структура. Выясняем цели сайта, аудиторию, основные сценарии посетителя и собираем структуру страниц. Помогаем составить техническое задание: как это делается.
- Дизайн. Макеты ключевых страниц с учётом вашего фирменного стиля, понятная навигация, читаемая типографика, аккуратные формы заявок.
- Адаптивная вёрстка. Сайт одинаково удобен на телефоне, планшете и компьютере. См. «Адаптивная вёрстка».
- Программирование и система управления. Редактор, в котором ваши сотрудники сами меняют тексты, добавляют статьи, товары и страницы без обращения к разработчику.
- Скорость. Оптимизация картинок, кэширование, лёгкий код. См. «Скорость загрузки сайта».
- SEO-основа. Корректные заголовки, мета-теги, карта сайта, чистые адреса, микроразметка. Закладываем сразу, а не после запуска: что именно.
- Аналитика и заявки. Подключение счётчиков, целей, уведомлений о новых заявках на почту или в мессенджер.
- Запуск и обучение. Перенос на хостинг, проверка, инструкция для сотрудников.
Технологический стек
Мы подбираем инструмент под задачу, а не наоборот. Для простых лендингов и небольших сайтов — статическая сборка, которая быстро загружается и почти не ломается. Для сайтов с регулярными публикациями — система управления контентом. Для порталов и личных кабинетов — полноценный серверный код на популярных языках и фреймворках, база данных и API. Все решения документируем, чтобы вы не зависели от одного исполнителя.
Поддержка после запуска
Сайт — живой продукт. Мы можем взять на себя обновления, резервные копии, мониторинг доступности, мелкие правки и развитие: новые разделы, формы, интеграции. Формат — по обращениям или с абонентской платой с гарантированным временем реакции. См. «Поддержка и развитие сайта после запуска». Если нужно понять, что вам больше подходит, прочитайте «Лендинг или многостраничный сайт» и «Сайт для B2B-компании».
Глоссарий
Если часть терминов в тексте и на сайте незнакома, вот краткий словарь. Мы старались давать определения простым языком, без лишней теории.
Синтетические данные
Данные, созданные программно, а не собранные в реальном мире. У нас это изображения, нарисованные по 3D-моделям, вместе с автоматической разметкой.
Датасет
Набор данных для обучения и проверки модели: изображения плюс разметка (рамки, маски, метки).
Разметка (аннотация)
Информация о том, что и где изображено на кадре. Бывает в виде рамок, масок, ключевых точек, классов.
Bounding box (баундинг-бокс)
Прямоугольная рамка вокруг объекта. Самый простой и распространённый вид разметки для детекции.
Маска сегментации
Выделение объекта по контуру, пиксель за пикселем. Точнее рамки и нужна, когда важна форма.
Инстанс-сегментация
Сегментация, различающая отдельные экземпляры одного класса: не просто «пиксели бутылок», а «бутылка один, бутылка два». Сравнение подходов — в статье «Семантическая и инстанс-сегментация».
Детекция объектов
Задача найти на изображении объекты определённых классов и указать их положение. Основы — в статье «Детекция объектов».
Ключевые точки
Отмеченные точки на объекте: углы, суставы, отверстия. Используются для оценки позы и ориентации.
6DoF
Шесть степеней свободы: три координаты положения и три угла поворота. Полное описание положения твёрдого тела в пространстве.
Карта глубины
Изображение, в котором каждый пиксель хранит расстояние до поверхности. Нужно роботам и задачам с трёхмерным пониманием сцены.
Рендеринг
Построение изображения из 3D-сцены по законам оптики. Результат зависит от качества моделей, материалов и освещения.
PBR-материалы
Физически корректное описание поверхности: шероховатость, металличность, прозрачность. Делают рендер похожим на реальную фотографию.
HDRI
Панорамное изображение с широким динамическим диапазоном, которое используется как источник света и окружения в сцене.
Доменная рандомизация
Приём, при котором параметры сцены (свет, фон, материалы, ракурсы) случайно варьируются в широких пределах, чтобы модель не привязывалась к конкретным условиям.
Domain gap
Разрыв между обучающими (синтетическими) и реальными данными. Чем он меньше, тем лучше модель работает на реальных кадрах.
Аугментация
Искусственное увеличение разнообразия данных: повороты, изменения яркости, обрезка, шум, замена фона. Мы применяем её и к реальным, и к синтетическим датасетам, подробнее на странице «Аугментация датасетов».
Дообучение (fine-tuning)
Дополнительное обучение уже обученной модели на небольшом наборе данных, чтобы подстроить её под конкретные условия.
mAP, IoU, precision, recall
Метрики качества детектора: пересечение рамок, доля верных срабатываний, доля найденных объектов и сводная оценка по всем классам.
Edge-устройство
Вычислительное устройство рядом с камерой (на производстве, в машине, на роботе), которое обрабатывает данные на месте. Требует лёгких моделей, о чём в статье «Компьютерное зрение на edge-устройствах».
Ещё вопросы
Ответы на самые частые вопросы собраны на странице «Вопросы и ответы». Здесь — менее очевидные вопросы, которые нам задают на этапе обсуждения проекта.
Можно ли заказать датасет для объекта, которого ещё не существует?
Да, это один из сильных сценариев. Если есть эскиз, чертёж или 3D-модель будущего изделия, мы создадим датасет ещё до выпуска первого образца. К моменту запуска производства модель уже обучена, и проверка качества или подача деталей начнётся без паузы.
Какие форматы аннотаций вы выдаёте?
COCO, YOLO, Pascal VOC и другие популярные форматы, а также собственные структуры под ваш конвейер. Один и тот же датасет можно выдать сразу в нескольких форматах. Если у вас нестандартный, пришлите описание: мы напишем конвертер.
Что, если у нас прозрачные, блестящие или сложные по форме предметы?
Это работает, но требует больше времени на материалы. Стекло, глянцевый металл и жидкости мы моделируем физически корректно, с преломлением и бликами. Рекомендуем сначала запросить пилот на таких объектах, чтобы вместе убедиться, что результат вас устраивает.
Можно ли получить датасет под конкретную камеру?
Да, и это желательно. Достаточно паспорта камеры и нескольких реальных кадров. Мы настроим разрешение, поле зрения, шум и искажения, чтобы рендер выглядел так, как будет выглядеть реальный поток.
Как вы поступаете, если модель на синтетике работает хуже, чем ожидалось?
Разбираем ошибки на ваших реальных кадрах и находим причину: не хватает определённого ракурса, неверные материалы, слишком чистый фон, неправильный масштаб. Затем корректируем сцены и генерируем исправленную версию. Типичные причины описаны в статье «Типичные ошибки при обучении моделей зрения».
Можно ли использовать датасет с любой архитектурой модели?
Да. Датасет не привязан к конкретной сети: YOLO, Faster R-CNN, Mask R-CNN, трансформеры, собственные разработки. Мы лишь следим, чтобы формат и размеры изображений подходили вашему конвейеру обучения. Пример обучения — в разборе обучения YOLO.
Можно ли дополнить датасет позже, если появятся новые классы?
Конечно. Сцены, материалы и модели сохраняются, поэтому добавление новых классов или условий делается быстрее, чем первая сборка. Версии датасета нумеруются, а изменения фиксируются в описании.
Вы помогаете с обучением самой модели?
Наша основная специализация — данные. Но мы можем провести пробное обучение для проверки датасета и дать рекомендации по настройке. Если нужна полноценная разработка модели и встраивание в процесс, обсудим это в рамках автоматизации.
Работаете ли вы с видео, а не только с фотографиями?
Да. Мы можем рендерить последовательности кадров с движением камеры и объектов, сохраняя согласованную разметку между кадрами и идентификаторы экземпляров. Подходит для трекинга, анализа движения и задач на потоке.
Как проходит общение в ходе проекта?
Один ответственный менеджер, регулярные промежуточные результаты (просмотр кадров до массовой генерации) и ясные точки согласования. Вы всегда знаете, на каком этапе работа и что требуется от вас. Общая схема — на странице «Как мы работаем».
Почему Syntidata
Рынок синтетики растёт, и выбрать исполнителя непросто. Вот что отличает нас в работе, без громких обещаний. Больше о компании — на странице «О компании».
Собственная технология
Мы не перепродаём чужие сервисы, а используем собственный конвейер 3D-моделирования, рендера и разметки. Это значит, что мы можем подстроить любой этап под вашу задачу и отвечаем за результат целиком.
Датасеты под задачу
Каждый проект начинается с вашей задачи и реальных условий, а не с готового шаблона. Создаём в том числе объекты, которых нет в реальности, и сцены, которые невозможно снять.
Честность в оценке
Говорим, когда синтетика не нужна или нужна лишь частично. Измеряем качество на ваших реальных кадрах, а не на красивых картинках. Лучше потерять заказ, чем получить недовольного заказчика.
Точная разметка
Маски, рамки, глубина, ключевые точки и позы получаются из геометрии сцены, без человеческих ошибок и расхождений между разметчиками. Разметка согласована на всём объёме датасета.
Прозрачность процесса
Пилот до массовой генерации, понятные отчёты по качеству, версии датасета с описанием изменений. Вы видите промежуточные результаты и влияете на них.
Больше, чем датасеты
Если датасет — только первый шаг, мы можем помочь встроить модель в процессы, автоматизировать отчётность или сделать сайт. Одна команда вместо нескольких подрядчиков.
Конфиденциальность
Ваши чертежи, образцы и данные остаются вашими. Соглашение о неразглашении, ограниченный доступ, удаление материалов после проекта.
Удобство работы
Москва, русскоязычная поддержка, понятные договорённости и быстрые ответы. Напишите на [email protected] — расскажем, подойдёт ли синтетика вашей задаче, и предложим тестовый датасет.
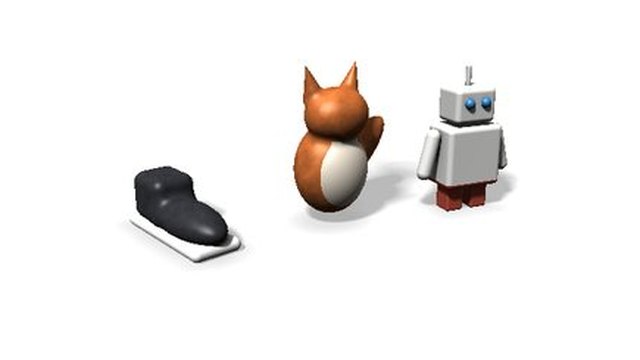
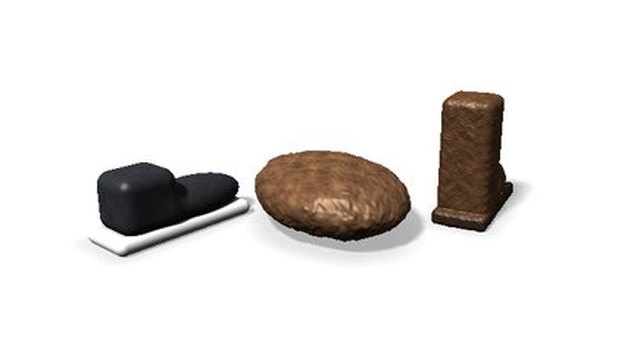
Сцены из датасетов
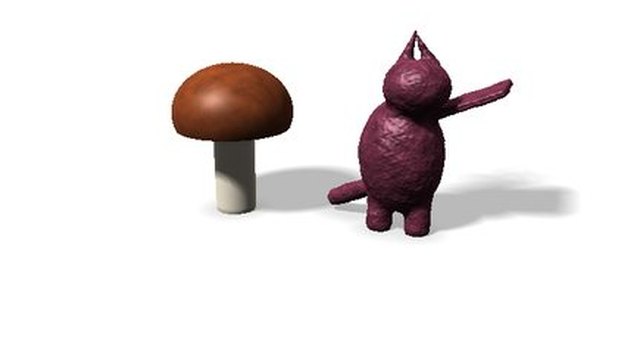
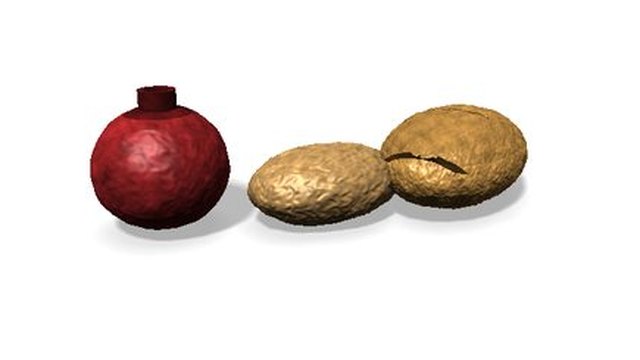
Объекты собираются в сцены с перекрытиями, разным масштабом и освещением. Часть кадров рендерится в «глиняном» режиме для проверки геометрии перед назначением материалов.
Часто задаваемые вопросы
Работает ли модель, обученная на синтетике, на реальных фото?
Да, если датасет подготовлен с достаточной рандомизацией и проверен на реальных кадрах. Обычно мы рекомендуем дообучение на небольшом наборе реальных изображений — это сокращает разрыв между доменами.
Что нужно от нас для начала работы?
Описание задачи, список классов, несколько примеров реальных изображений из условий эксплуатации и, если есть, чертежи или фото объектов с разных сторон.
Можно ли получить тестовый датасет?
Да, тестовый датасет предоставляется по запросу. Он позволяет оценить качество изображений и разметки до заказа основного объёма.
Сколько изображений нужно для обучения?
Зависит от числа классов и сложности условий. Для простого детектора хватает нескольких тысяч кадров, для промышленной модели — десятки тысяч. Подробно — в статье «Сколько изображений нужно для обучения детектора».
Кому принадлежат права на датасет?
Права на созданный по заказу датасет и разметку передаются заказчику по договору.
Вы делаете только датасеты?
Основное направление — синтетические данные, но мы также занимаемся автоматизацией процессов и разработкой сайтов.
Из блога
 Синтетические данные
Что такое синтетические данные и почему о них заговорили все
Синтетические данные — это изображения и разметка, созданные программно, а не снятые камерой. Разбираем, как они устроены, откуда взялся интерес к ним и в каких задачах они действительно работают.
 Компьютерное зрение
Обучение YOLO на собственном датасете: пошаговый разбор
YOLO давно стала рабочей лошадкой детекции: быстро обучается и легко разворачивается. Разбираем весь процесс на собственном датасете и честно говорим, где обычно ломается.
 Разметка данных
Виды разметки изображений: обзор
От выбора вида разметки зависит и стоимость датасета, и то, чему в итоге научится модель. Разбираем основные виды аннотаций, их плюсы и ограничения и даём простую схему выбора.
 3D-моделирование
PBR-материалы и почему от них зависит реалистичность
Физически корректные материалы (PBR) определяют, как поверхность реагирует на свет. Разбираем, из чего они состоят, как их настраивать и почему для синтетических датасетов это вопрос качества, а не красоты.
 Автоматизация
 бизнес-процессов: с чего начать
Автоматизация начинается не с выбора программы, а с понимания, где именно теряется время. Разбираем, как найти подходящие процессы, посчитать выгоду и запустить первый результат за несколько недель.
 Разработка сайтов
SEO на этапе разработки: что заложить сразу
Исправлять SEO после запуска дороже, чем заложить его при создании сайта. Перечисляем технические и структурные решения, которые стоит принять до первой строки кода.
-
Синтетические данные
Сколько изображений нужно для обучения детектора
Универсального числа нет, но есть рабочие ориентиры и способы оценить потребность до того, как вы потратили бюджет. Разбираем факторы, диапазоны и метод кривой обучения.
-
Компьютерное зрение
Метрики детекции: mAP, IoU, precision и recall без путаницы
Метрики детекции часто пересказывают формулами, но редко объясняют, что за ними стоит. Разбираем IoU, precision, recall, AP и mAP на понятных примерах и показываем, как по ним принимать решения.
 Разметка данных
Форматы аннотаций: COCO, YOLO, Pascal VOC и другие
Формат аннотаций кажется технической мелочью, пока обучение не падает с ошибкой или рамки не съезжают на пол-кадра. Объясняем, как устроены популярные форматы, чем отличаются и как безопасно конвертировать.
 Автоматизация
Скрипты, боты и RPA: что выбрать для рутины
Для одной и той же рутинной задачи можно написать скрипт, сделать бота или настроить программного робота. Объясняем, чем эти подходы отличаются, и даём простые критерии выбора.
 Синтетические данные
Как проверить качество синтетического датасета
Красивые рендеры ничего не гарантируют. Показываем, как проверить синтетический датасет до обучения и после него, какие метрики смотреть и когда останавливать проект.
 Разработка сайтов
Сайт для B2B-компании: что действительно важно
В B2B сайт не продаёт сразу, он помогает пройти путь от первого интереса до запроса на расчёт. Рассказываем, какие элементы действительно работают, а какие только украшают.
Заявка
Опишите задачу — мы предложим состав датасета и подготовим тестовую партию. Можно написать напрямую на [email protected].